
SEO Spam Search Reflection หน้า Search และ Review ถูกใช้โฆษณาเว็บพนันได้อย่างไร
คำโฆษณาเว็บพนันที่ปรากฏคู่กับ website ขององค์กรใน Google อาจมาจากหลายช่องทาง ทั้งหน้า Search ที่นำคำค้นมาแสดงกลับ คอมเมนต์หรือรีวิวที่ผู้ใช้โพสต์ และเนื้อหาที่ถูกแทรกหลังระบบถูกเจาะ แต่ละกรณีต้องตรวจและแก้คนละจุด
ตัวอย่าง URL ของ NASA APOD ที่มีข้อความโฆษณาอยู่ในพารามิเตอร์ค้นหาเป็นกรณีที่ใช้ฝึกแยกหลักฐานได้ดี เพราะ URL อย่างเดียวยังบอกไม่ได้ว่าหน้าเว็บตอบกลับอะไร Google เคยแสดงข้อความใด และมีลิงก์ออกจริงหรือไม่
flowchart TD
    A["พบข้อความสแปมบนเว็บไซต์"] --> B{"ข้อความเข้ามาทางไหน"}
    B -->|"ค่าจาก URL"| C["หน้า Search"]
    B -->|"เนื้อหาที่ผู้ใช้โพสต์"| D["คอมเมนต์หรือรีวิว"]
    B -->|"การแก้ไขโดยไม่ได้รับอนุญาต"| E["ระบบถูกเจาะ"]
    C --> F["ตรวจการแสดงคำค้นและ indexing"]
    D --> G["ตรวจสิทธิ์และขั้นตอนเผยแพร่"]
    E --> H["หาช่องทางเข้าและรับมือเหตุการณ์"]
คำโฆษณาเว็บพนันบน URL ของ NASA บอกอะไรได้บ้าง
ตัวอย่าง URL ของ APOD (Astronomy Picture of the Day) มีข้อความโฆษณาอยู่ในพารามิเตอร์ tquery ดังนี้
https://apod.nasa.gov/cgi-bin/apod/apod_search?tquery=<ข้อความโฆษณาเว็บพนัน>
| หลักฐาน | สิ่งที่ยืนยันได้ |
|---|---|
URL ที่มีข้อความอยู่ใน tquery | ข้อความนั้นอยู่ในค่าพารามิเตอร์ของ URL |
| ภาพผลค้นหา Google พร้อมวันที่บันทึก | Google แสดง URL, title หรือ snippet ตามภาพ ณ เวลานั้น |
| HTML หรือ archived response ของ URL เดียวกัน | เนื้อหาที่หน้าเว็บตอบกลับ และตำแหน่งที่แสดงคำค้น |
<a href="…"> ใน HTML หรือ DOM ของหน้า | มีลิงก์ออกไปยังปลายทางนั้น |
| หลักฐานการเข้าถึงหรือแก้ไขระบบโดยไม่ได้รับอนุญาต | ใช้ประกอบการยืนยันว่าระบบถูกเจาะ |
URL เพียงอย่างเดียวยังไม่ยืนยันว่ามีการส่งคำขอนั้นจริง เซิร์ฟเวอร์ตอบกลับอะไร หรือ Google เคย index หน้านั้น
สำหรับ APOD ในบทความนี้ กลไกที่ทำให้ข้อความปรากฏบนหน้าเว็บหรือในผลค้นหายังเป็นข้อสันนิษฐาน การใช้ชื่อโดเมน NASA ใน URL ไม่ได้ยืนยันว่า NASA เป็นผู้เขียนหรือรับรองข้อความโฆษณานั้น
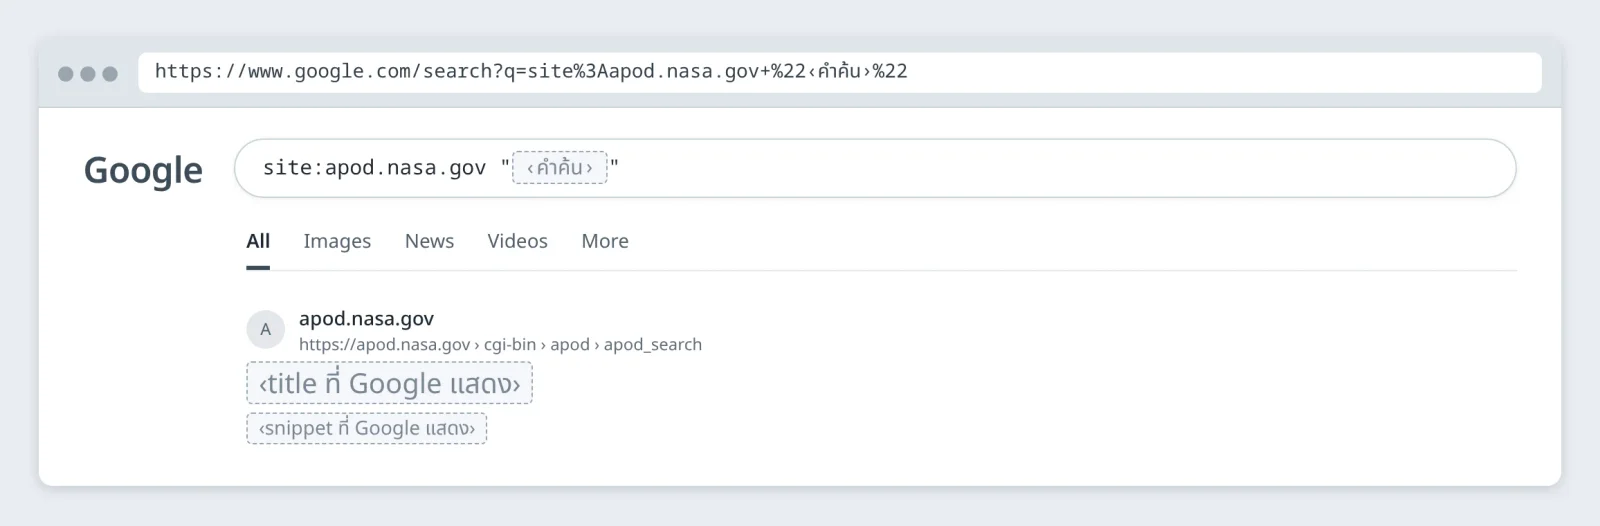 ภาพผลค้นหา Google ของ apod.nasa.gov
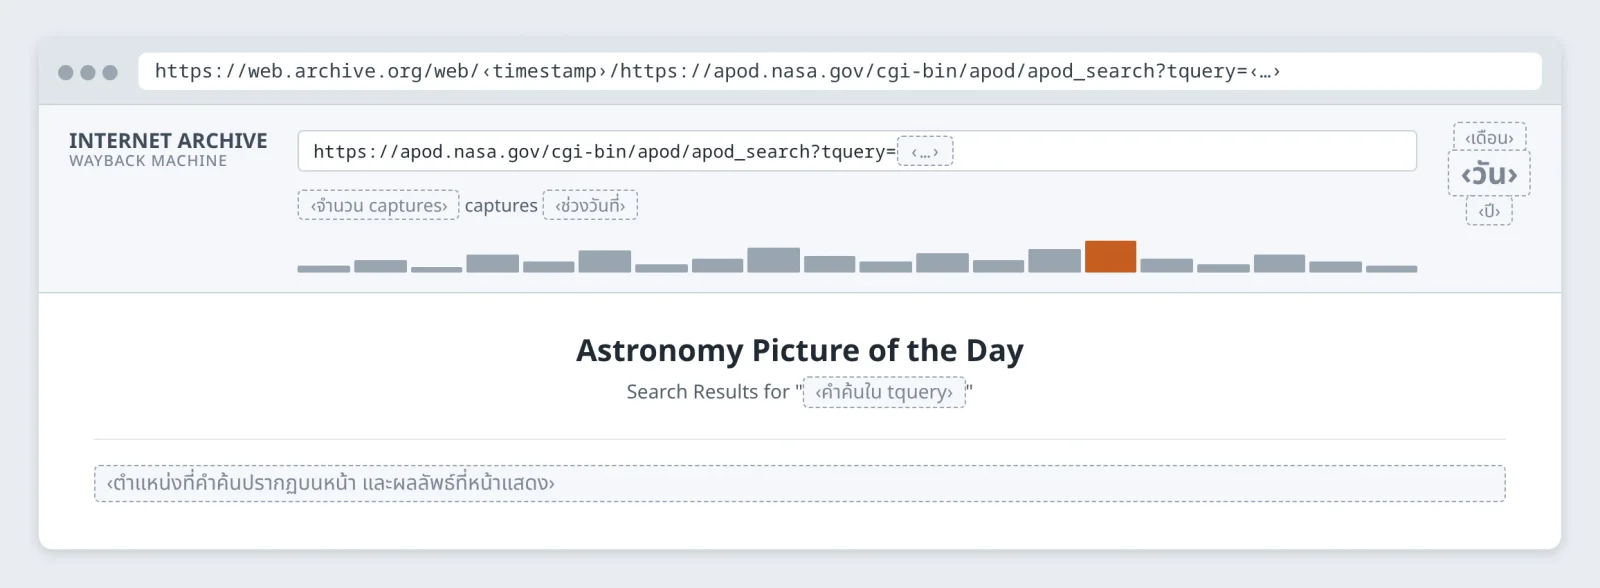 Wayback Machine snapshot ของหน้า APOD
เหตุการณ์ของ NASA JPL ที่มีรายงานแยกต่างหาก
NASA JPL เคยถูกเจาะและใช้ทำ SEO spam เป็นคนละเหตุการณ์กับ APOD และใช้ยืนยันกลไกของกรณี APOD ไม่ได้
- 21 ตุลาคม 2010: Sucuri รายงานว่าเว็บย่อยของ NASA JPL ถูกเจาะและใช้ในเครือข่าย SEO spam รวมถึงแจกจ่ายมัลแวร์ โดยมีตัวอย่างหน้าที่เกี่ยวข้องกับโฆษณายา
- 9 พฤษภาคม 2011: รายงานของ IDG News Service ที่เผยแพร่บน PCWorld ระบุว่าหน้าบนเว็บ JPL ถูกใช้โฆษณาซอฟต์แวร์ราคาถูก เช่น Adobe Creative Suite
หน้า Search ถูกใช้ทำ SEO Spam ได้อย่างไร
สมมติเซิร์ฟเวอร์รับคำค้นผ่านพารามิเตอร์ q
https://www.example.com/search?q=IL_SEO_TEST_20261026
แล้วนำคำค้นมาแสดงในหน้าเว็บ
<title>ผลการค้นหา: IL_SEO_TEST_20261026</title>

<h1>ผลการค้นหา</h1>
<p>คำค้น: IL_SEO_TEST_20261026</p>
<p>ไม่พบผลลัพธ์</p>
แม้ระบบจะไม่พบผลลัพธ์ ข้อความที่ผู้ใช้ส่งมาก็ยังอยู่ใน <title> และเนื้อหาของหน้า หากส่งข้อความโฆษณาแทน marker ข้อความนั้นก็อาจปรากฏบนหน้าค้นหาภายใต้ website ขององค์กร
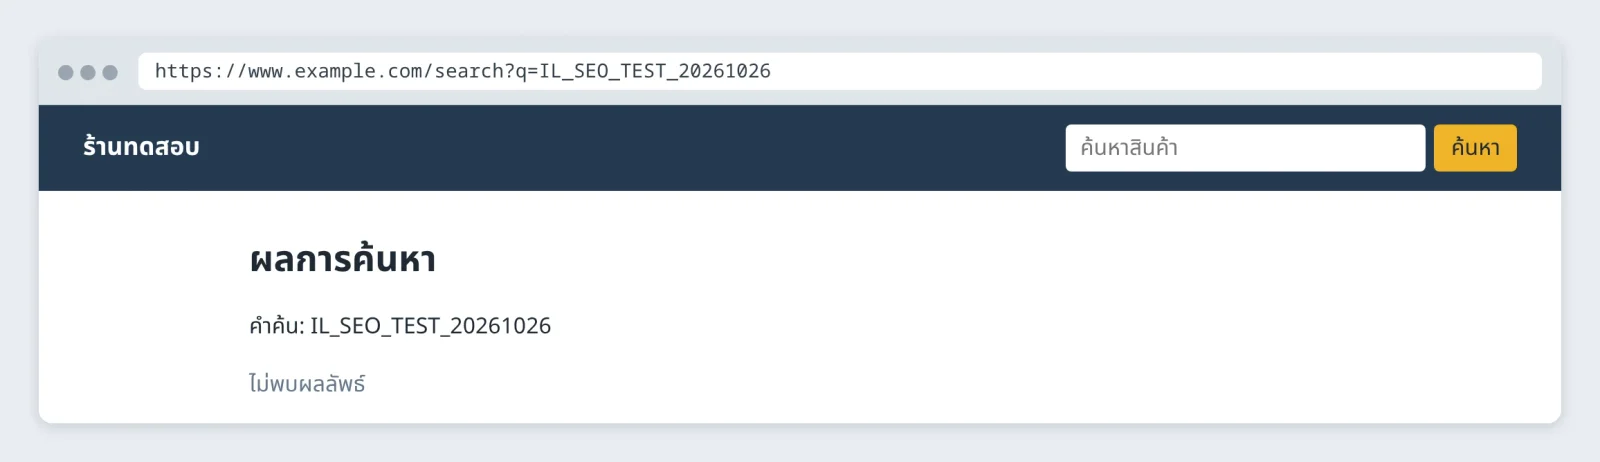 ตัวอย่างหน้าค้นหาที่แสดง marker IL_SEO_TEST_20261026 จาก URL
ตัวอย่างจำลอง: หน้า Search แสดงคำค้นกลับมา แม้ไม่พบผลลัพธ์
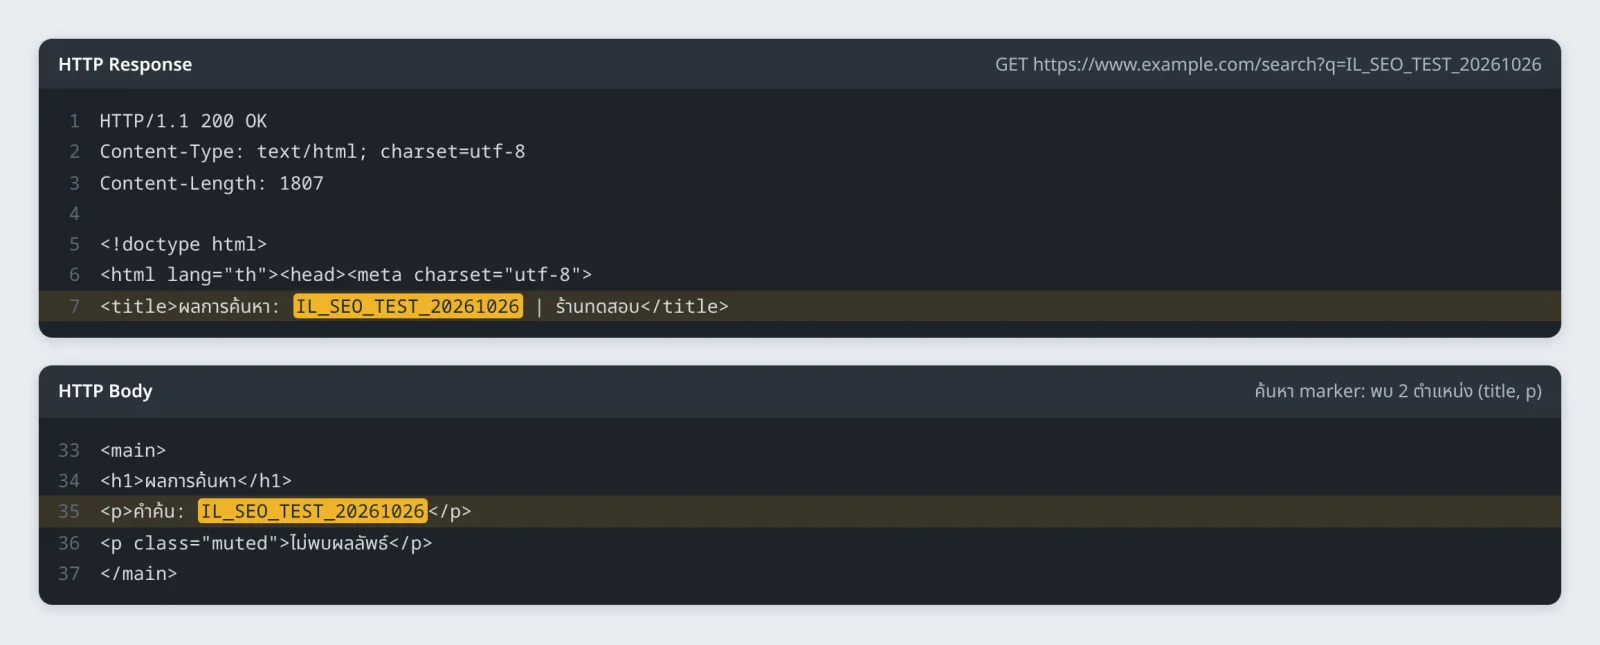 ตัวอย่าง HTML response ที่มี marker อยู่ใน title และ body
ตรวจตำแหน่งที่คำค้นปรากฏใน HTML ทั้ง <title> และเนื้อหาของหน้า
เมื่อ URL นี้ถูกค้นพบผ่านลิงก์จากเว็บไซต์อื่น crawler อาจเข้ามาอ่านหน้าและนำไปประมวลผลต่อได้
sequenceDiagram
    participant Spammer as Attacker
    participant Other as Compromised Website
    participant Site as Target Website
    participant Google as Google Search
    participant Visitor as User

    Spammer->>Other: วางลิงก์ไปยัง URL ที่มีข้อความโฆษณา
    Google->>Other: อ่านหน้าและพบลิงก์
    Google->>Site: ขอหน้า Search ตาม URL
    Site-->>Google: ตอบกลับ HTML ที่มีข้อความจากคำค้น
    opt Google เลือกเก็บหน้าและนำมาแสดง
        Visitor->>Google: ค้นหาคำที่เกี่ยวข้อง
        Google-->>Visitor: แสดงผลที่อาจมีข้อความจากหน้า Search
    end
การแสดงคำค้นกลับมาเป็นฟังก์ชันปกติของหน้าค้นหา ความเสี่ยงอยู่ที่ผู้ไม่ประสงค์ดีกำหนดข้อความบนหน้าที่พร้อมถูก index ได้ Google ไม่ได้ index ทุกหน้าที่ crawler เข้าถึง แต่ Google เองก็ยกตัวอย่างการใช้หน้าค้นหาภายในเว็บไซต์เผยแพร่คำค้นที่โฆษณาเว็บไซต์หรือบริการของบุคคลที่สามไว้แล้ว
เมื่อสแปมเข้ามาทางคอมเมนต์และรีวิวสินค้า
ผู้ไม่ประสงค์ดีใช้คอมเมนต์ รีวิวสินค้า และโปรไฟล์ผู้ใช้โพสต์โฆษณาได้เช่นกัน Google เรียกว่า User-generated spam (UGC spam) และมีคู่มือป้องกันโดยเฉพาะ
ตัวอย่างเช่น หน้าสินค้าที่ https://shop.example/products/shoe-123 มีผู้ใช้รีวิวว่า:
สินค้าดีครับ แนะนำโปรโมชันเพิ่มเติมที่ promotion.example
หากระบบบันทึกและเผยแพร่รีวิวทันที ผู้เข้าชมและ crawler ก็อาจอ่านโฆษณานั้นได้จากหน้าสินค้า โดยไม่ต้องมีคำค้นอยู่ใน URL
ข้อความสแปมที่ถูกเก็บใน database ยังไม่นับว่าเป็น Stored XSS หรือการเจาะเซิร์ฟเวอร์ หากส่งผ่านฟอร์มที่เปิดให้ใช้ ก็เป็นการใช้ฟังก์ชันในทางที่ผิด ส่วน XSS ต้องมีเงื่อนไขที่ทำให้ browser รันข้อมูลนั้นเป็น JavaScript ด้วย
กรณีรีวิวต่างจากหน้า Search ตรงที่หน้าสินค้าเป็นหน้าที่เรายังต้องการให้ปรากฏใน Google หากใส่ noindex ทั้งหน้า เนื้อหาสินค้าที่ถูกต้องจะถูกกันออกจากผลค้นหาไปด้วย จึงควรแก้ที่รีวิวและกระบวนการเผยแพร่ก่อน
ตรวจรีวิวที่เสี่ยงก่อนเผยแพร่
Google แนะนำให้ใช้ moderation กับกิจกรรมที่น่าสงสัยและติดตามพฤติกรรมบัญชี เงื่อนไขต่อไปนี้เป็นตัวอย่างการนำไปปรับใช้เพื่อให้เหมาะสมกับเว็บไซต์
| เหตุการณ์ | แนวทางจัดการ |
|---|---|
| ผู้ใช้ใหม่ส่งรีวิวครั้งแรก | เข้าคิวตรวจ หรือประเมินความเสี่ยงก่อนเผยแพร่ |
| รีวิวมี URL ภายนอก | ตรวจปลายทางและความเกี่ยวข้อง หากไม่จำเป็นอาจไม่อนุญาตให้ใส่ลิงก์ |
| ข้อความเดิมถูกโพสต์หลายสินค้า | ตรวจรีวิวและบัญชีที่เกี่ยวข้องเป็นกลุ่ม |
| โพสต์ถี่ผิดจากการใช้งานปกติ | จำกัดอัตราการส่งและเพิ่มขั้นตอนยืนยันตามความเสี่ยง |
| รีวิวที่อนุมัติแล้วถูกแก้ไข | ตรวจฉบับใหม่ก่อนเผยแพร่ ระหว่างนั้นแสดงฉบับเดิมที่อนุมัติแล้วต่อไป |
| มีผู้ใช้รายงานสแปม | ให้ผู้ดูแลตรวจ พร้อมติดตามการโพสต์ซ้ำ |
จุดที่ควรตรวจเพิ่มในระบบ:
- ตรวจข้อมูลนอกตัวรีวิวด้วย ทั้งหัวข้อ ชื่อผู้รีวิว ช่องเว็บไซต์ และคำบรรยายรูป หากชื่อหรือเว็บไซต์ในโปรไฟล์ถูกนำมาแสดงในรีวิวเก่า การแก้โปรไฟล์ก็อาจเปลี่ยนสิ่งที่ปรากฏในหลายหน้าได้พร้อมกัน
- ข้อมูลที่รออนุมัติต้องยังไม่ถูกส่งออกสู่สาธารณะ ไม่ใช่ส่งมาในหน้าแล้วซ่อนด้วย CSS ให้ตรวจทั้ง HTML, ข้อมูลที่ฝังให้ JavaScript ใช้, Public API, JSON-LD, feed, หน้าโปรไฟล์, ระบบค้นหาภายใน และ cache ส่วน preview สำหรับผู้เขียนหรือผู้ดูแลต้องตรวจสิทธิ์ก่อนแสดง
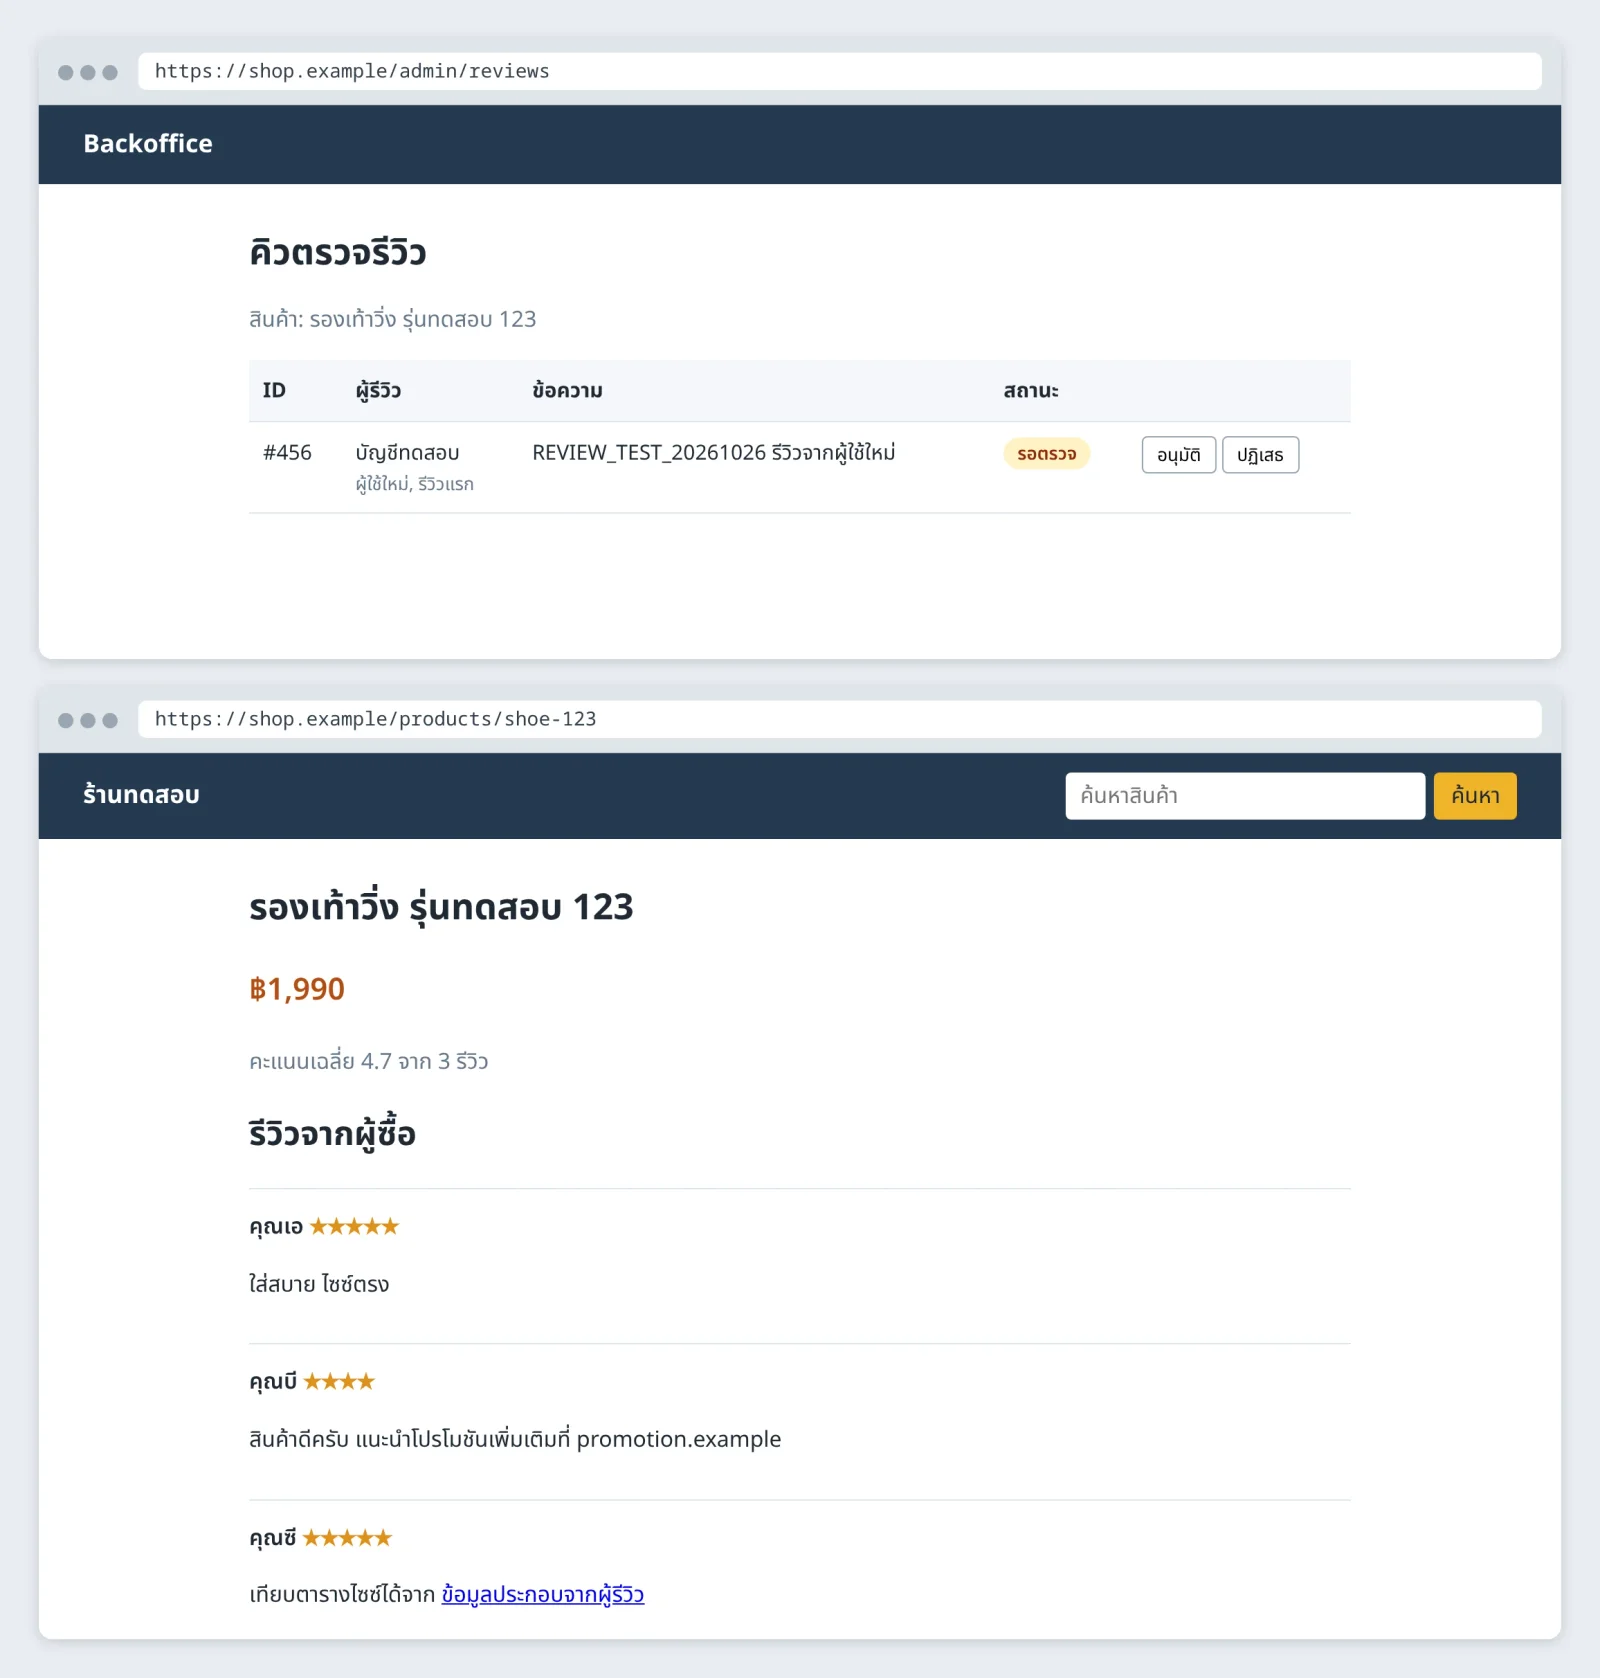 ตัวอย่างคิวตรวจรีวิวใน Backoffice เทียบกับหน้าสินค้าที่เปิดแบบไม่ล็อกอิน
ตัวอย่างจำลอง: รีวิวที่รออนุมัติยังไม่ถูกเผยแพร่บนหน้าสินค้า
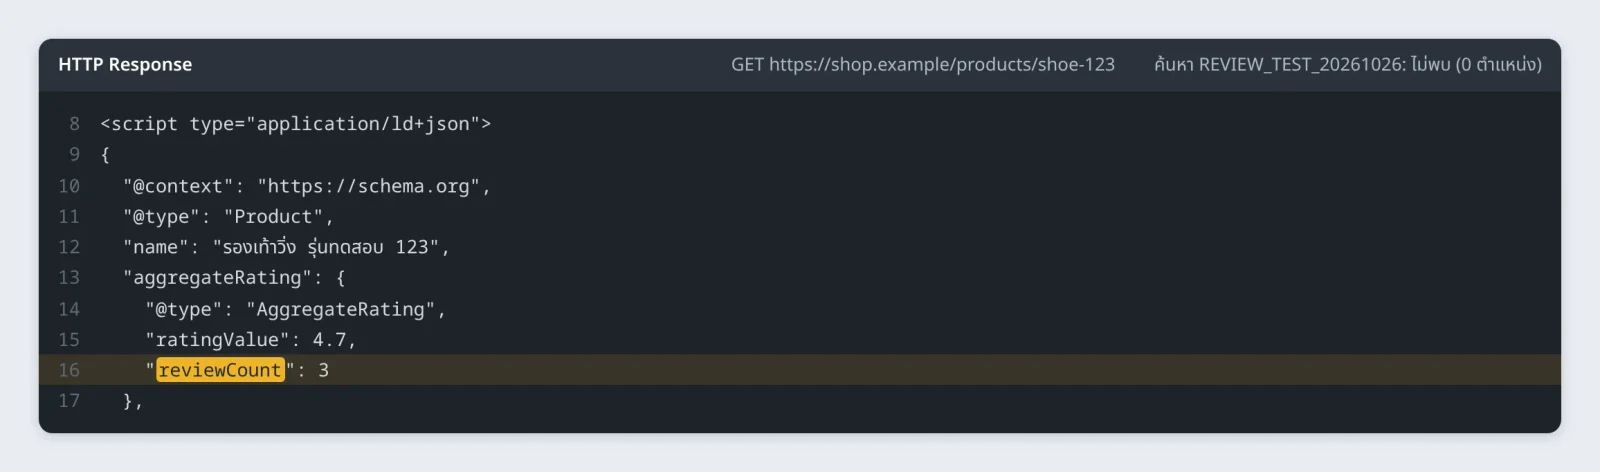 ตัวอย่างการตรวจ HTML และ JSON-LD ของหน้าสินค้าระหว่างรออนุมัติรีวิว
ตรวจด้วย marker ว่ารีวิวที่รออนุมัติไม่ได้ถูกส่งออกมาใน HTML หรือ JSON-LD
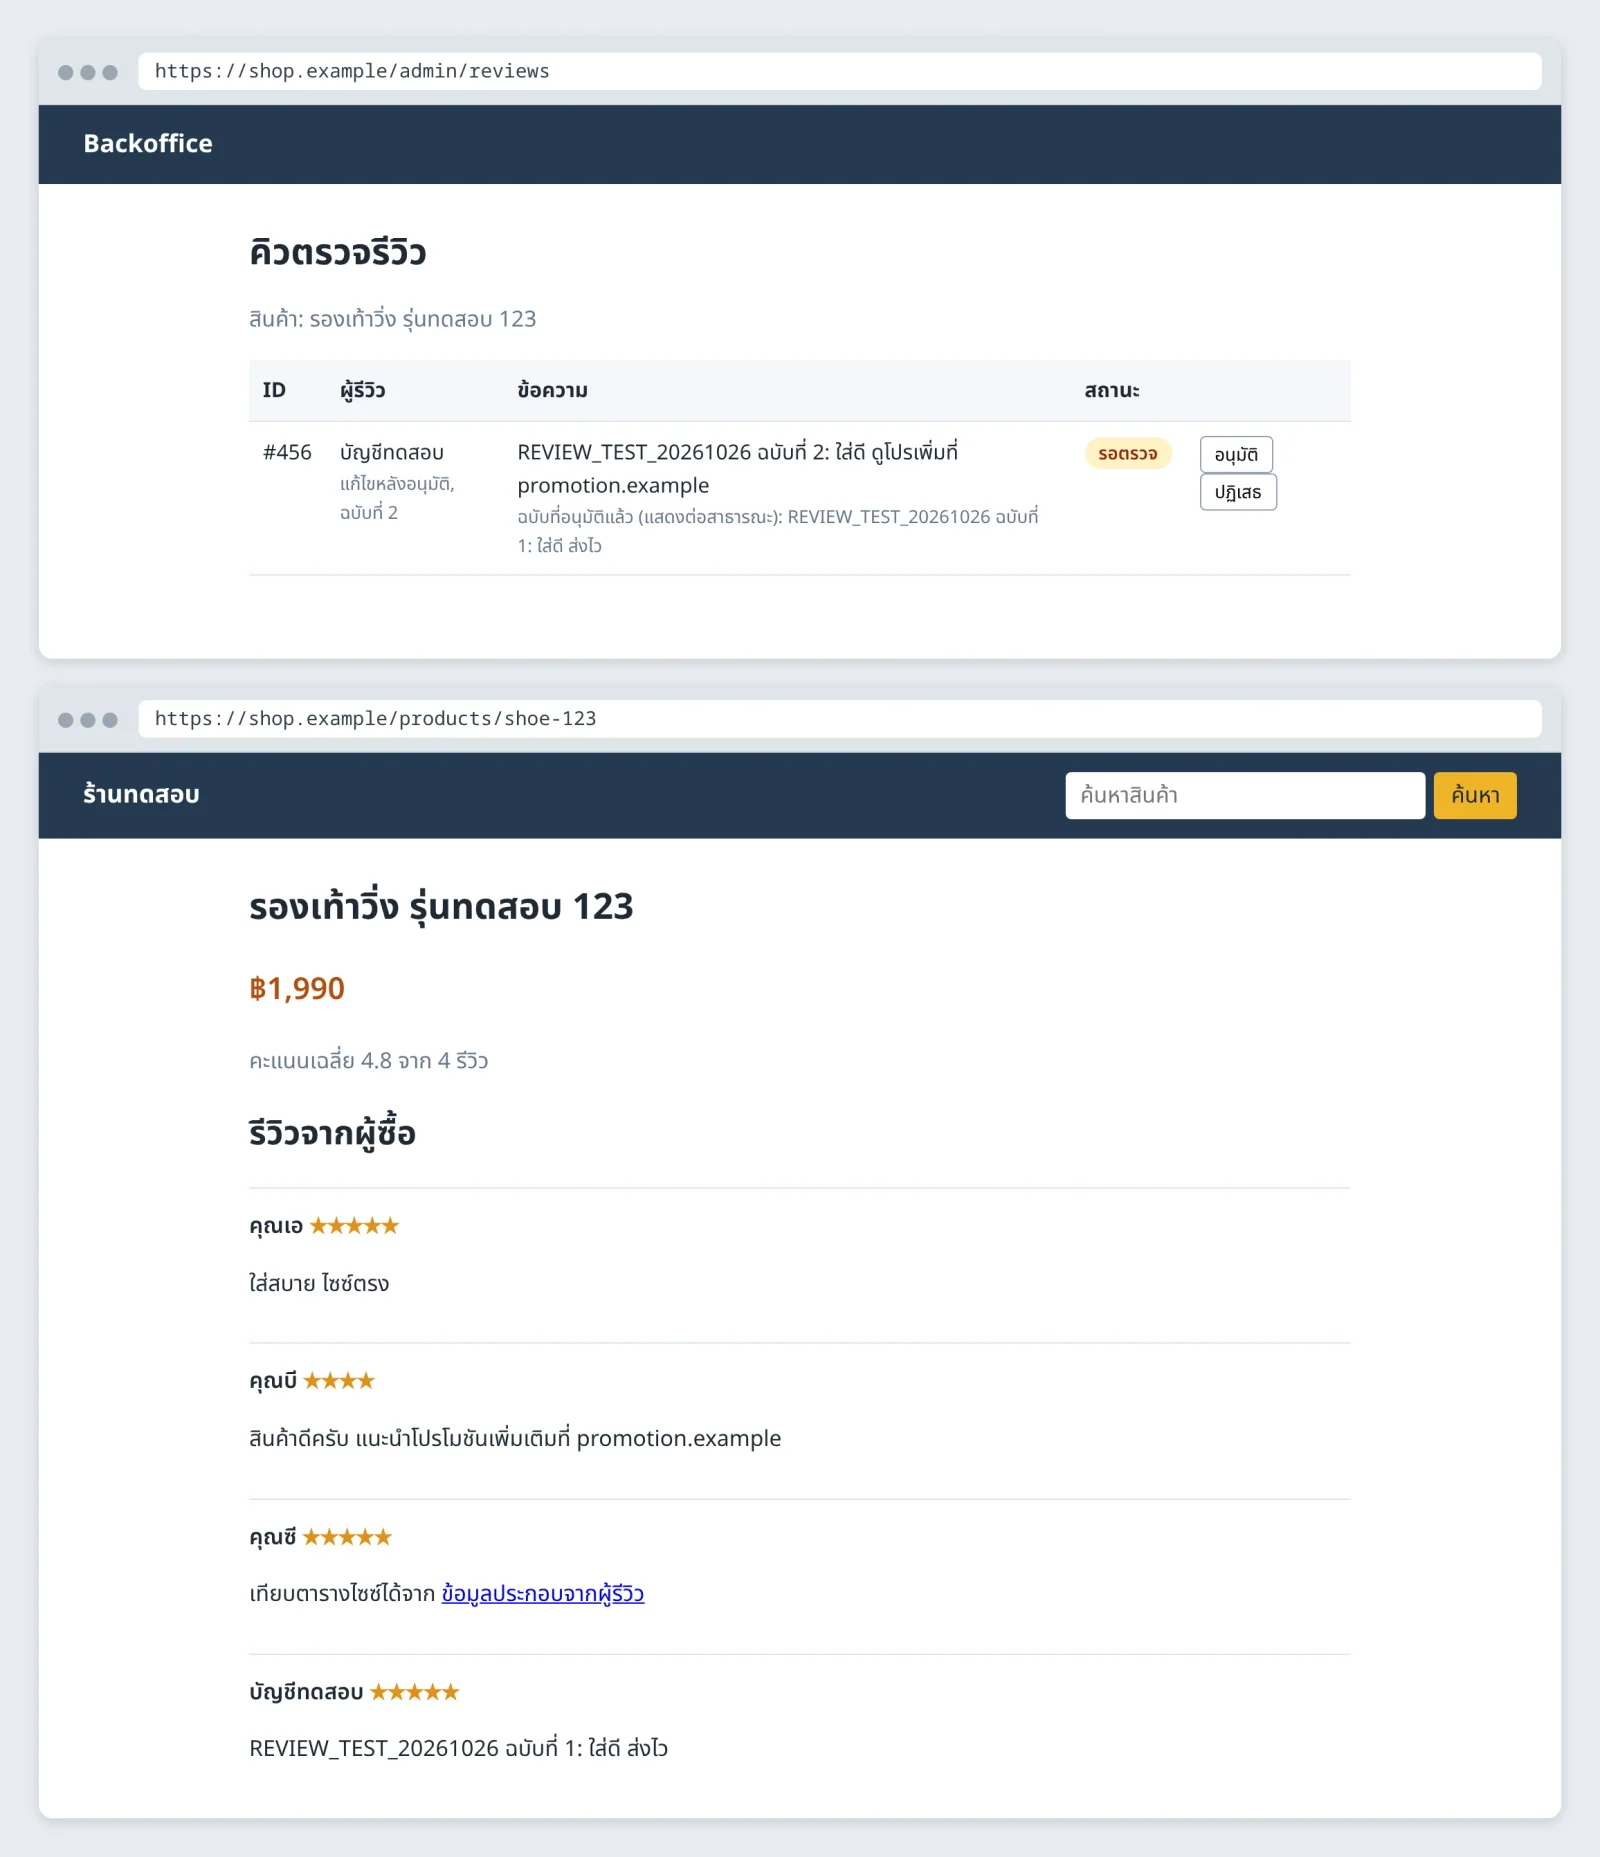 ตัวอย่างรีวิวฉบับแก้ไขที่รอตรวจขณะหน้าสินค้ายังแสดงฉบับเดิม
ฉบับแก้ไขกลับเข้าคิวตรวจ ส่วนหน้าสาธารณะแสดงเฉพาะฉบับที่อนุมัติแล้ว
ถ้ารีวิวมีลิงก์
รีวิวที่เป็นข้อความธรรมดาควรถูกแสดงด้วยการ escape ตาม context ที่นำไปแสดง หากรองรับ rich text ให้ใช้ sanitizer พร้อมกำหนด tag, attribute และ URL scheme ที่ยอมรับ การป้องกันต้องครอบคลุมหน้า moderation ใน Backoffice ด้วย เพราะผู้ดูแลอาจเป็นคนแรกที่เปิดดูข้อมูลนั้น
สำหรับลิงก์ที่อนุญาตให้เผยแพร่แล้ว ให้ระบุว่ามาจากผู้ใช้ด้วย rel="ugc" และอาจเพิ่ม nofollow ตามนโยบายของเว็บ
<a href="https://reference.example/" rel="ugc nofollow">
  ข้อมูลประกอบจากผู้รีวิว
</a>
Attributes เหล่านี้ไม่ได้ลบข้อความสแปม ไม่ได้ห้ามผู้อ่านกดลิงก์ และไม่ได้ป้องกัน XSS หากยืนยันแล้วว่ารีวิวเป็นสแปม ควรลบออกทันที
สแปมอาจไม่มีลิงก์เลยก็ได้ ผู้โพสต์อาจทิ้งชื่อแบรนด์ เบอร์ติดต่อ หรือชื่อบัญชีไว้ให้ผู้อ่านไปค้นต่อ การตรวจจึงต้องดูเนื้อหาและบริบทด้วย
ควบคุมข้อความรีวิวที่ปรากฏใน snippet
หากไม่ต้องการให้ Google นำข้อความในส่วนรีวิวไปแสดงเป็นข้อความตัวอย่างใต้ผลค้นหา สามารถใช้ data-nosnippet กับ div, span หรือ section ได้
<section class="product-reviews" data-nosnippet>
  <!-- รีวิวที่ผ่านการตรวจแล้ว -->
</section>
data-nosnippet ควบคุมเฉพาะ snippet ไม่ใช่ noindex เฉพาะรีวิว และไม่ได้แก้สแปมที่ยังอยู่บนหน้า Structured data ภายใน element นั้นยังอาจถูกใช้ในผลค้นหาได้ จึงต้องตรวจ JSON-LD แยก และต้องแลกกับการที่รีวิวที่มีประโยชน์จะหายจาก snippet ด้วย
หลังนำรีวิวสแปมออก ให้ตรวจว่า:
reviewBodyและข้อมูลผู้รีวิวที่เป็นสแปมถูกลบออกจาก JSON-LD แล้ว- จำนวนรีวิวและคะแนนรวมใน
AggregateRatingสอดคล้องกับข้อมูลที่ยังใช้ได้ - หน้าอื่นที่ดึงรีวิวเดียวกันไปแสดงได้รับการอัปเดตแล้ว
Google กำหนดให้เนื้อหารีวิวที่ทำ structured data ต้องเข้าถึงได้จากหน้าที่เกี่ยวข้อง และไม่ให้ใส่รีวิวปลอมลงในหน้าหรือ markup
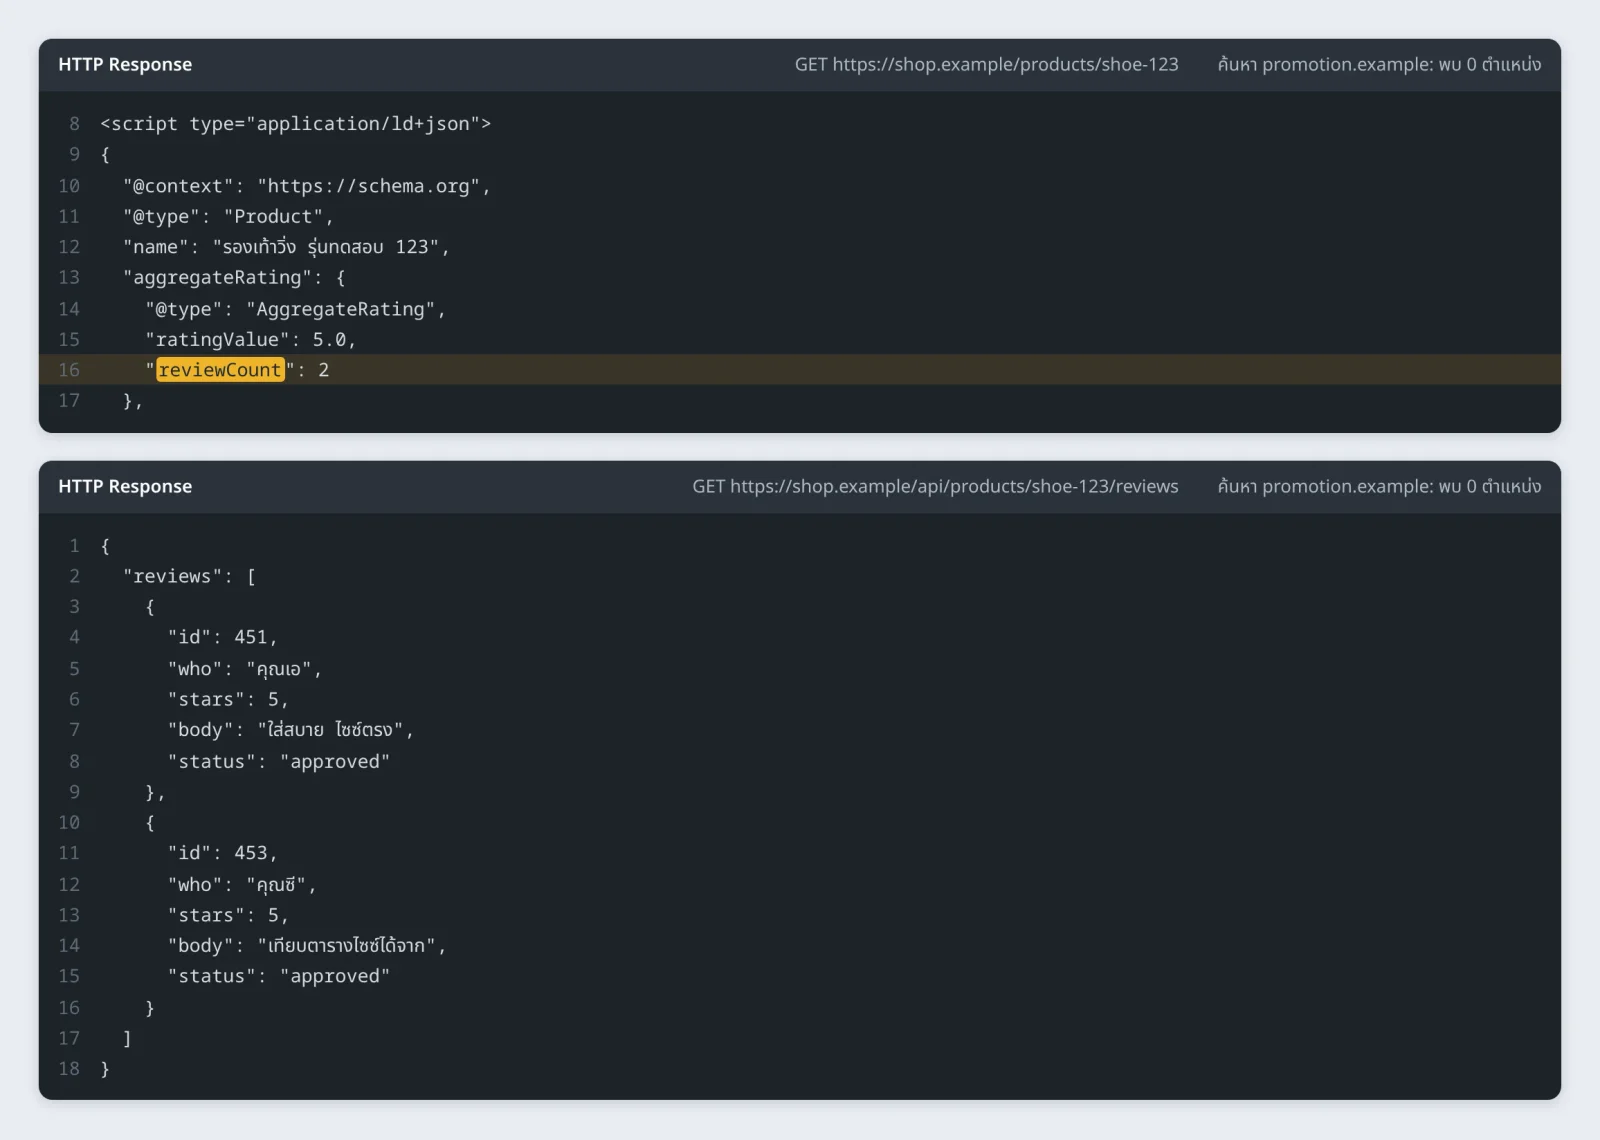 ตัวอย่างการตรวจ JSON-LD และ API หลังนำรีวิวสแปมออก
ตรวจทั้ง HTML, API และ JSON-LD หลังนำรีวิวออก รวมถึงจำนวนรีวิวและคะแนนเฉลี่ย
มีคำโฆษณาบนหน้าเว็บ เท่ากับมี Backlink หรือถูกเจาะแล้วหรือไม่
ข้อความที่ดูคล้ายกันอาจเกิดจากคนละสาเหตุ การรายงานผลควรแยกสิ่งที่ตรวจพบออกจากข้อสรุปที่ยังต้องพิสูจน์
| สิ่งที่พบ | ข้อสรุปที่ทำได้ |
|---|---|
| คำค้นปรากฏเป็นข้อความบนหน้า | คำค้นถูก reflect กลับมา แต่ยังไม่ยืนยัน HTML injection หรือ XSS |
| ชื่อโดเมนภายนอกปรากฏเป็นตัวหนังสือ | มีการกล่าวถึงโดเมนนั้น แต่ยังไม่ยืนยันว่ามีลิงก์ออก |
มี <a href> ไปยังเว็บภายนอก | มีลิงก์ออก ต้องตรวจต่อว่าถูกสร้างจากฟังก์ชันหรือข้อมูลใด |
| Input เปลี่ยนโครงสร้าง HTML ได้ | มีประเด็น HTML injection ที่ต้องประเมินแล้วแต่กรณี |
| Input ทำให้โค้ดทำงานใน browser ได้ | มีประเด็น XSS ตามเงื่อนไขที่ทดสอบ |
| สแปมอยู่ในไฟล์หรือ database | ต้องตรวจที่มา ว่าเป็นการโพสต์ผ่านฟังก์ชันหรือการแก้ไขโดยไม่ได้รับอนุญาต |
OWASP นิยาม reflected XSS ว่า input ต้องถูกส่งกลับในรูปแบบที่ browser ประมวลผลเป็นโค้ดได้ การ reflect อย่างเดียวจึงยังไม่ใช่ XSS
Backlink ต้องดูทั้งต้นทางและปลายทาง
ลิงก์จากเว็บสแปมมาที่หน้า Search ขององค์กรเป็นลิงก์เข้า และเป็นช่องทางให้ crawler พบ URL นั้น ส่วนลิงก์จากหน้า Search ขององค์กรไปยังเว็บสแปมเป็นลิงก์ออก ซึ่งต้องแยกจากการกล่าวถึงโดเมนเป็นข้อความ:
<!-- กล่าวถึงโดเมนเป็นข้อความ -->
<p>คำค้น: promotion.example</p>

<!-- มีลิงก์ออก -->
<a href="https://promotion.example/">ตัวอย่างปลายทางภายนอก</a>
ควรตรวจทั้ง HTML ที่เซิร์ฟเวอร์ส่งมาและ DOM หลัง JavaScript ทำงาน Google อ่านลิงก์ได้โดยทั่วไปจาก <a> ที่มี href ซึ่งรวมถึงลิงก์ที่ JavaScript สร้างในรูปแบบเดียวกัน
ระบบ auto-link ก็อาจเปลี่ยนข้อความ URL ให้เป็นลิงก์ออกได้ แม้จะป้องกัน HTML injection แล้ว ส่วนการพบลิงก์ยังไม่ยืนยันว่า Google นับเป็นประโยชน์ด้านอันดับให้เว็บไซต์ปลายทาง
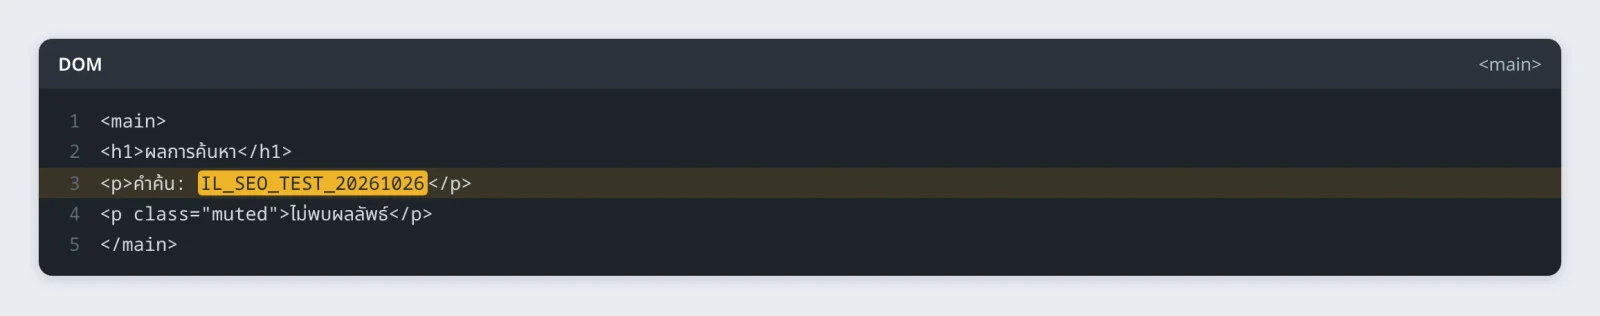 ตัวอย่าง DOM ของหน้าค้นหาที่แสดง marker เป็นข้อความ
ตรวจว่า marker เป็น text ภายใน <p> หรือมี element ลิงก์ถูกสร้างขึ้นด้วย
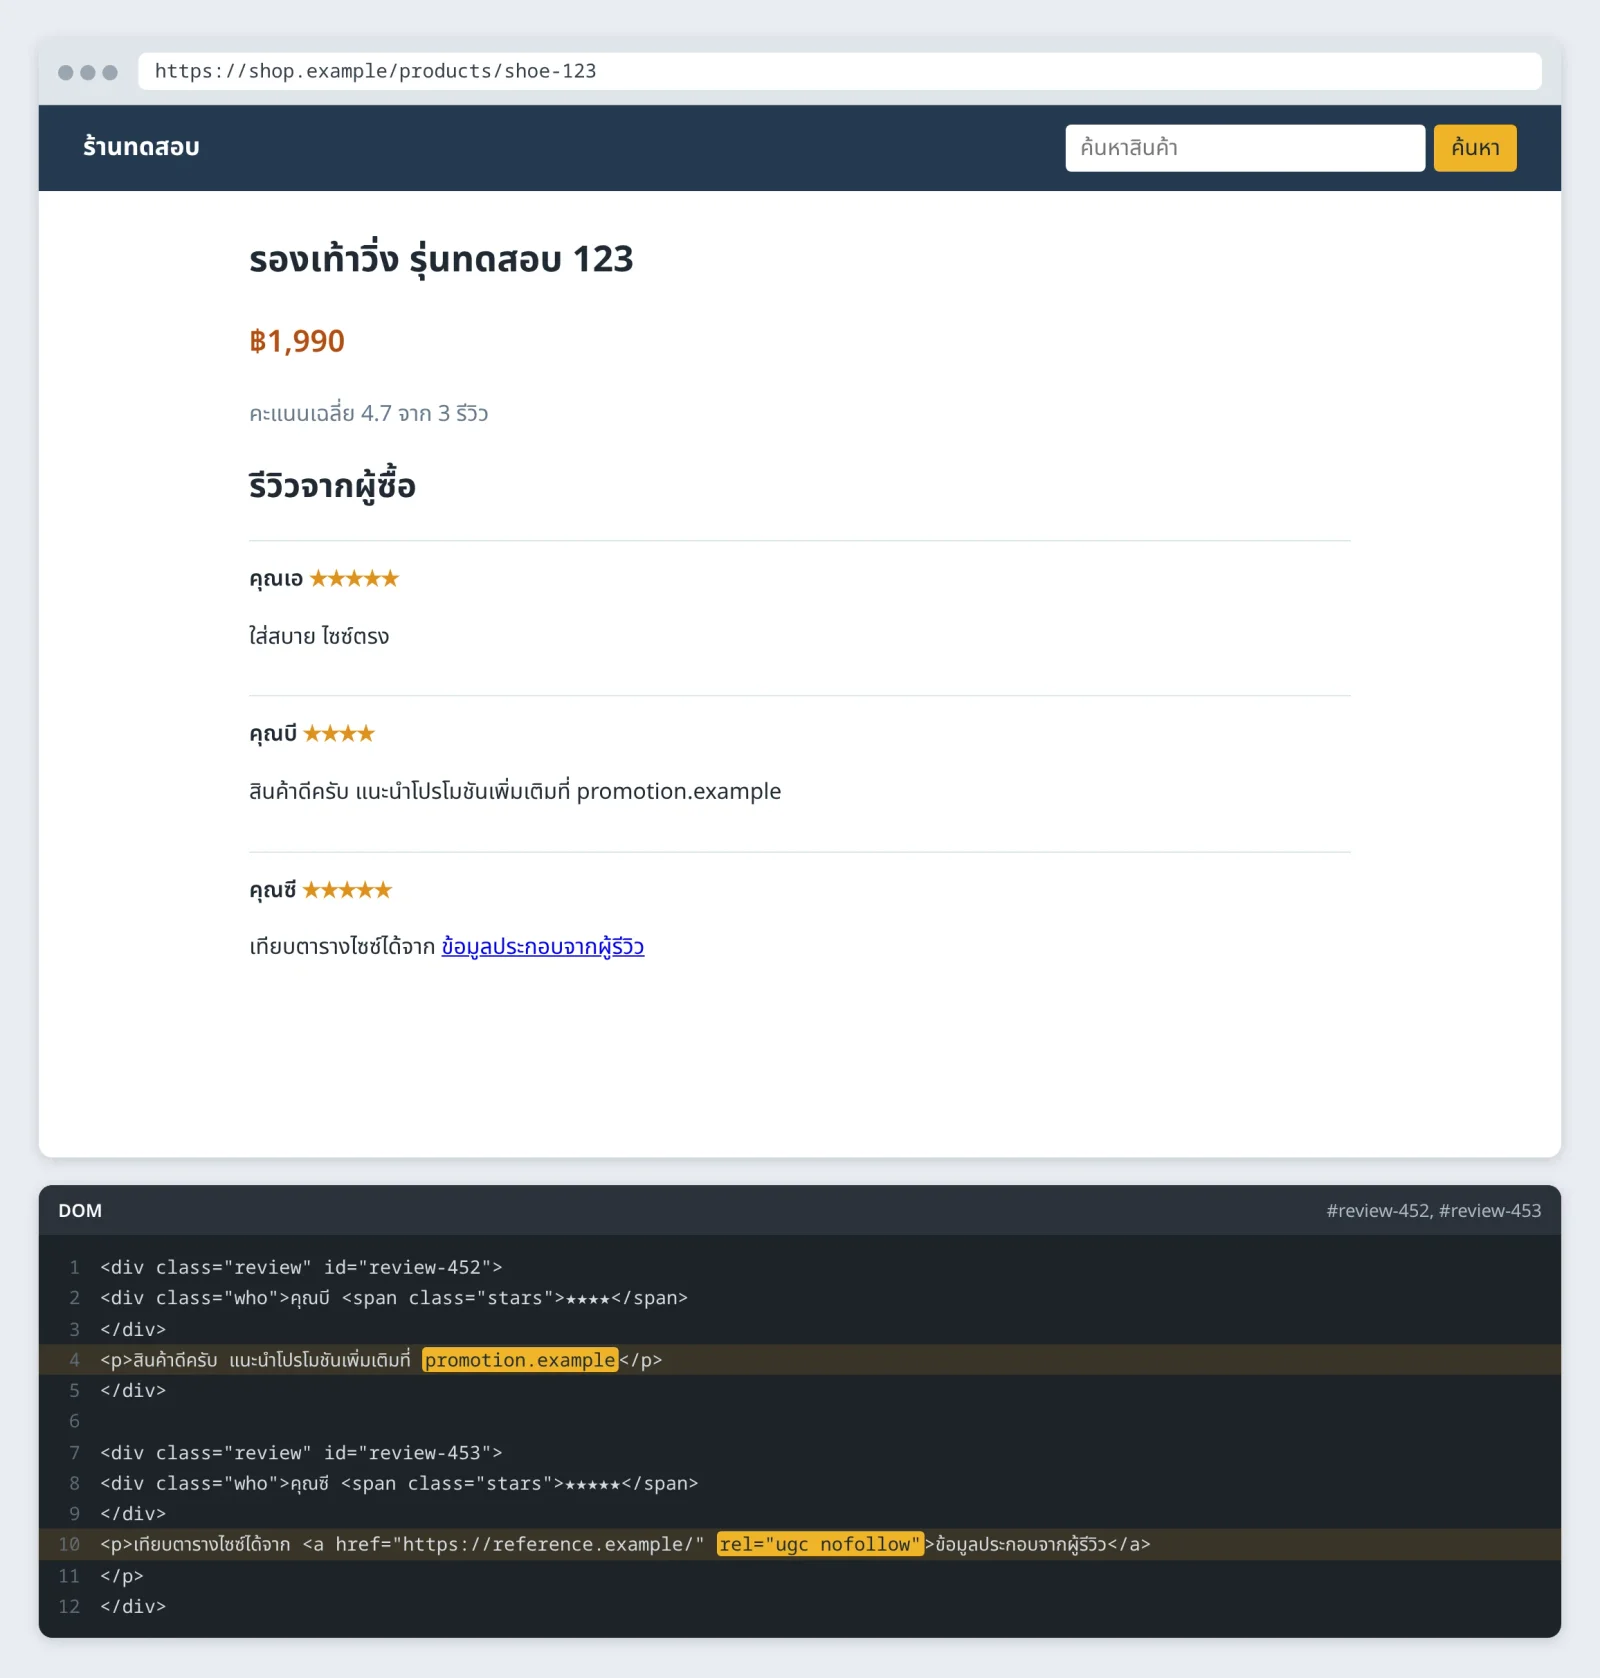 ตัวอย่างการกล่าวถึงโดเมนเป็นข้อความเทียบกับลิงก์ในรีวิว
ข้อความที่กล่าวถึงโดเมนกับ <a href> เป็นหลักฐานคนละแบบ ส่วน rel="ugc nofollow" ใช้ระบุความสัมพันธ์ของลิงก์
ตรวจหา SEO Spam ด้วย Google Search, Search Console และ Pentest
ตรวจจาก Google Search
เริ่มจากคำค้นที่จำกัดขอบเขตมายังโดเมนของตนเอง
site:example.com "เครดิตฟรี"
site:example.com "คาสิโน"
site:example.com "casino"
site:example.com inurl:search "เครดิตฟรี"
บันทึก URL, title, snippet และวันที่ตรวจไว้ หากพบผลที่ผิดจากเนื้อหาของเว็บไซต์ ให้ใช้ URL นั้นเป็นจุดเริ่มตรวจ response และข้อมูลต้นทาง
Google ระบุว่าผลจาก site: ไม่ใช่รายการ URL ทั้งหมดใน index การค้นไม่พบจึงยังใช้ยืนยันว่าเว็บไซต์ไม่มีสแปมไม่ได้
ตรวจใน Google Search Console
หากสามารถเข้า Google Search Console ได้ แนะนำให้ทำ:
- ดูคำค้นและ URL ที่ไม่เกี่ยวกับธุรกิจใน Performance report
- ตรวจสถานะของ URL ที่สงสัยผ่าน URL Inspection
- เทียบข้อมูลที่ Google บันทึกไว้กับผล Test live URL
- เปิดดูรายงาน Security Issues และ Manual Actions
URL Inspection แสดงข้อมูลที่ Google บันทึกไว้ ส่วน Test live URL ตรวจหน้าเว็บปัจจุบัน ความแตกต่างระหว่างสองส่วนนี้ช่วยให้เห็นว่าเว็บไซต์แก้แล้ว แต่ Google ยังใช้ข้อมูลเก่าอยู่หรือไม่
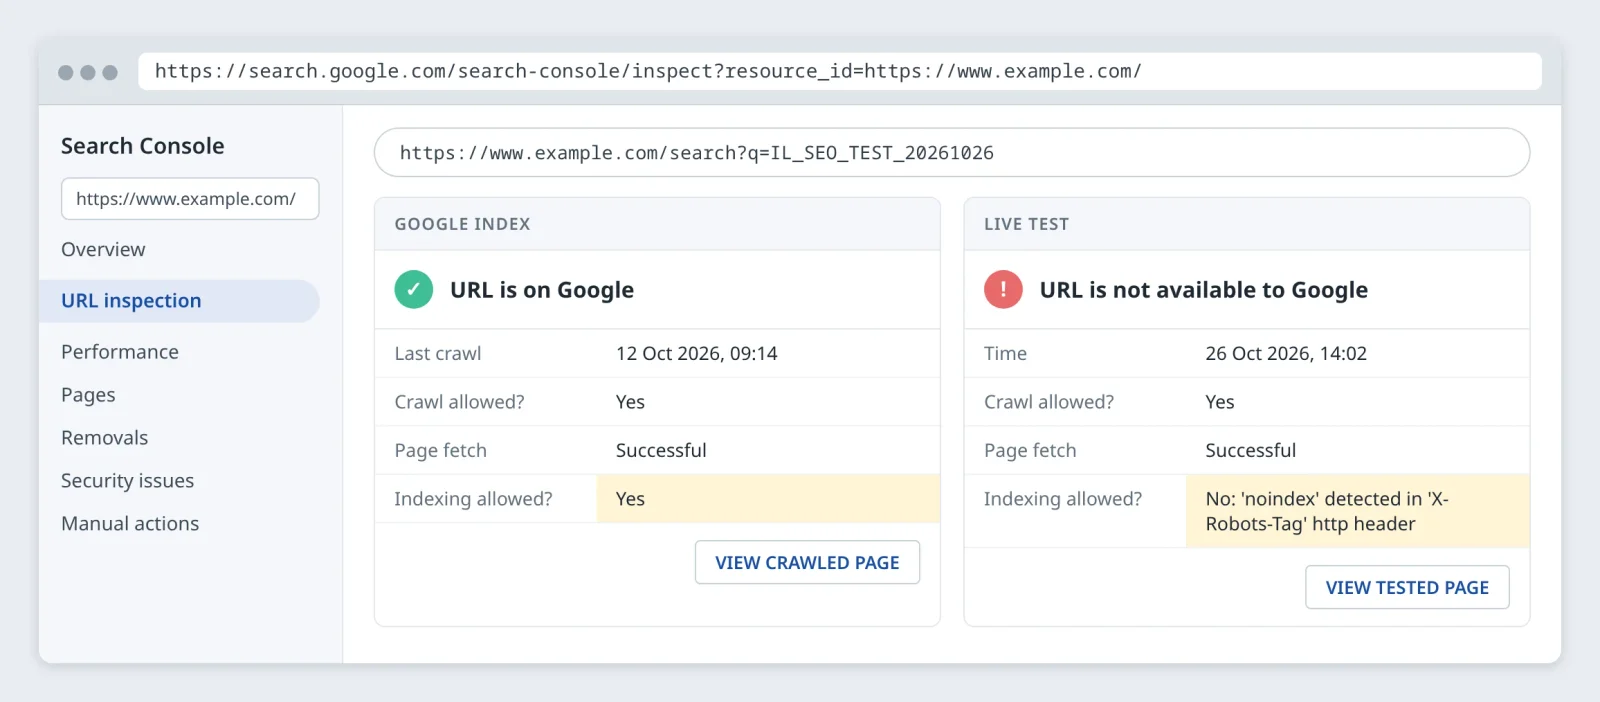 URL Inspection เทียบข้อมูลใน index กับผล Live test ของหน้าค้นหา
ข้อมูลใน index ยังเป็นผลจาก crawl ก่อนแก้ ส่วน Live test เห็น noindex จาก X-Robots-Tag แล้ว
ทดสอบฟังก์ชันโดยตรง
ในการตรวจสอบเบื้องต้นแนะนำให้ส่ง marker เช่น IL_SEO_TEST_A แล้วไล่ตรวจตามตารางนี้:
| จุดตรวจ | คำถามที่ต้องตอบ |
|---|---|
| Search endpoint และพารามิเตอร์ | มี /search, ?q=, ?s=, ?query=, ?tquery= หรือ endpoint เก่าที่ยังเปิดอยู่หรือไม่ |
| ตำแหน่งที่แสดงคำค้น | Input ไปอยู่ใน <title>, meta description, heading, body, attribute หรือ structured data ตรงไหนบ้าง |
| การสร้างลิงก์และ redirect | ระบบแปลงข้อความเป็นลิงก์ หรือให้ input กำหนดปลายทางได้หรือไม่ |
| การควบคุม indexing | แต่ละหน้าตอบ status code, robots meta และ X-Robots-Tag อย่างไร |
| การแสดงผลแต่ละรูปแบบ | HTML ต้นฉบับกับ DOM หลัง render ต่างกันหรือไม่ มีเงื่อนไขตามอุปกรณ์หรือ referrer หรือไม่ |
| เนื้อหาใน database และไฟล์บนเซิร์ฟเวอร์ | มีหน้า CMS, ไฟล์, บัญชีผู้ดูแล หรือ redirect rule ที่ไม่ทราบที่มาหรือไม่ |
| รีวิวและคอมเมนต์ | การอนุมัติ การแก้ไข และ API ใช้ Rule การเผยแพร่เดียวกันหรือไม่ |
และทดสอบเพิ่ม:
- ทดสอบภาษาไทย คำค้นยาว คำค้นว่าง และกรณีไม่พบผลลัพธ์
- ส่งรีวิวผ่าน API โดยตรง เพื่อตรวจว่าข้ามการอนุมัติหรือกำหนดสถานะ "ซื้อสินค้าจริง" เองได้หรือไม่
- ตรวจ HTML injection หรือ XSS เพิ่มเติมตามตำแหน่งที่นำ input ไปแสดง
ผลสแกนที่ไม่พบ XSS ยังไม่ได้ตอบว่าฟังก์ชันถูกใช้ทำ SEO spam ได้หรือไม่ เพราะข้อความที่ escape ถูกต้องแล้วก็ยังอาจถูกเผยแพร่และ index ได้ scope ของ Pentest จึงควรระบุให้ครอบคลุมการใช้ฟังก์ชันในทางที่ผิดและการตั้งค่า indexing ด้วย
ตรวจ Logs และการเปลี่ยนแปลงของระบบ
ดูคำขอที่มีข้อความไม่เกี่ยวกับธุรกิจ จำนวนคำขอไปหน้า Search ที่เพิ่มผิดปกติ และ URL ที่เพิ่งปรากฏ หากมีข้อบ่งชี้ว่าระบบถูกแก้ไข ให้เทียบช่วงเวลาเหล่านั้นกับการเปลี่ยนไฟล์ ข้อมูลใน CMS และกิจกรรมของบัญชีผู้ดูแล
แก้หน้าเว็บอย่างไรให้ปิดต้นเหตุ
ควบคุมการนำ input ไปแสดง
แนะนำให้:
- ใช้ template engine ที่ escape ข้อมูลให้อัตโนมัติ เช่น เปลี่ยน
<เป็น<ก่อนแสดงผล และเลือกวิธี escape ให้ตรงกับตำแหน่งที่ข้อมูลไปอยู่ เพราะข้อความใน HTML, ใน attribute และใน URL ต้อง escape ต่างกัน - ถ้าใช้ JavaScript ใส่คำค้นลงในหน้า ให้ใช้
textContentแทนinnerHTML - ปิดการแปลงคำค้นเป็นลิงก์อัตโนมัติ (auto-link) เพราะทำให้เกิดลิงก์ออกไปยังโดเมนที่ผู้ไม่ประสงค์ดีใส่มา
ส่วน input validation ให้กำหนดความยาว รูปแบบ และวิธีจัดการพารามิเตอร์ซ้ำ โดยยังรองรับภาษาไทยและข้อความที่ผู้ใช้จำเป็นต้องค้นหา การใช้ blacklist คำพนันเพียงอย่างเดียวไม่ครอบคลุมรูปแบบข้อความที่เปลี่ยนแปลงได้
กำหนดว่าหน้าใดควรปรากฏใน Google
สำหรับหน้า Search ที่รับคำค้นอิสระและไม่จำเป็นต้องปรากฏใน Google สามารถกำหนดใน <head> ของ template:
<meta name="robots" content="noindex">
หรือส่ง HTTP response header:
X-Robots-Tag: noindex
ใช้วิธีใดวิธีหนึ่งก็พอ แต่ crawler ต้องเข้าถึงหน้าเพื่ออ่านคำสั่ง หากบล็อก URL เดียวกันใน robots.txt ด้วย Google อาจไม่เห็น noindex
Output encoding กับ noindex ทำหน้าที่ต่างกัน การ escape HTML ช่วยให้ input ถูกแสดงเป็นข้อความอย่างปลอดภัย แต่ข้อความนั้นยังอาจเป็นโฆษณาได้ ส่วน noindex ควบคุมการปรากฏในผลค้นหา ไม่ได้แก้ XSS หรือจำกัดการเข้าถึงหน้าเว็บ
นโยบาย indexing จึงควรกำหนดตามประเภทหน้า ไม่เหมารวมว่า URL ทุกตัวที่มี query parameter ต้องถูกตัดออกจาก Google
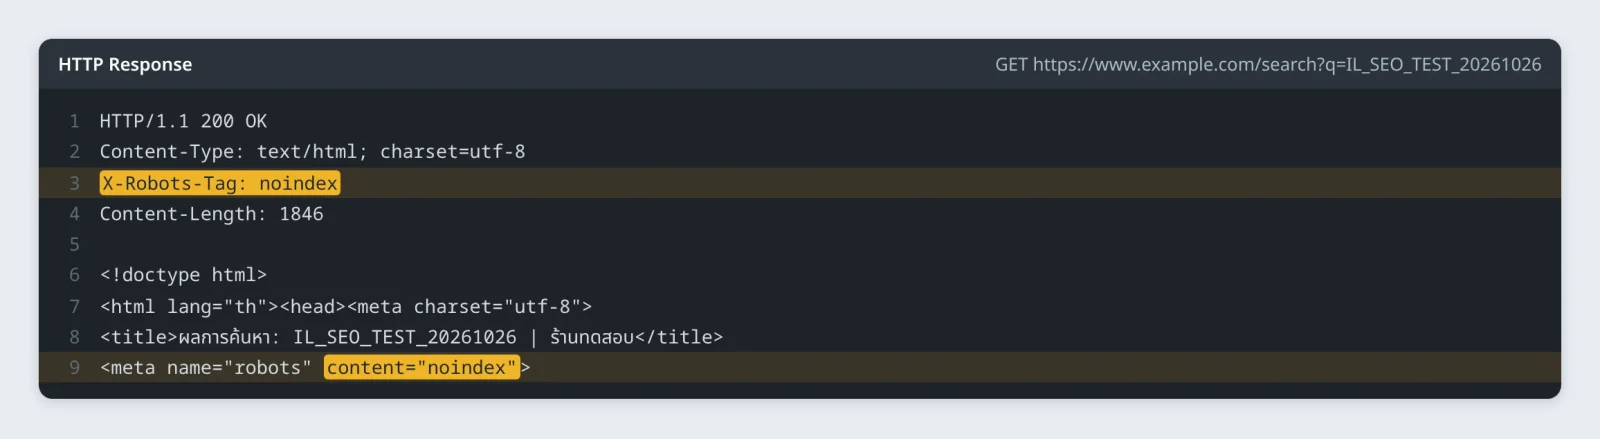 ตัวอย่างการตรวจ noindex จาก response header และ HTML ของหน้า Search
ตรวจ noindex จาก response header หรือ meta tag ตามวิธีที่ใช้
จัดการเนื้อหาและ URL สแปมเดิม
| สถานการณ์ | แนวทางแก้ |
|---|---|
| หน้าสแปมถูกลบทิ้ง | Response 404 Not Found หรือ 410 Gone |
| หน้าปกติถูกแทรกสแปม | กู้เนื้อหาที่ถูกต้องและปิดช่องทางที่ทำให้ถูกแก้ไข |
| หน้า Search ยังต้องใช้งาน | แก้การแสดง input และกำหนด indexing policy ของหน้าค้นหา |
| รีวิวหรือคอมเมนต์เป็นสแปม | ลบออก และตรวจสอบขั้นตอนการอนุมัติอีกที |
| Cache ยังมีเนื้อหาเดิม | Clear Cache ในฝั่งของ CDN และ Server |
สำหรับหน้าที่ลบทิ้ง ไม่ควรแสดงเพียงข้อความ "ไม่พบหน้า" แต่ยังตอบ 200 OK Google ระบุว่า URL ที่ตอบ 4xx ยกเว้น 429 จะถูกลบออกจาก index เมื่อระบบประมวลผลสถานะนั้น
หากพบหลักฐานการเจาะระบบ การลบหน้าสแปมอย่างเดียวไม่พอ ต้องหาช่องทางเข้าและสิ่งที่ผู้โจมตีทิ้งไว้ด้วย
ข้อจำกัดของมาตรการที่มักถูกนำมาใช้
| มาตรการ | สิ่งที่ต้องเข้าใจ |
|---|---|
rel="canonical" | เป็นสัญญาณเลือกหน้าตัวแทนของเนื้อหาซ้ำ Google ระบุว่าเป็นเพียง hint จึงไม่ใช่คำสั่งลบหน้าสแปม |
rel="nofollow" / rel="ugc" | ระบุความสัมพันธ์ของลิงก์ ไม่ได้นำหน้าต้นทางออกจากผลค้นหา |
| WAF / rate limit | ช่วยลดการใช้ฟังก์ชันในทางที่ผิด แต่ยังต้องแก้การแสดง input และการเผยแพร่เนื้อหา |
| Disavow | ใช้กับลิงก์ที่ชี้เข้าหาเว็บไซต์ ไม่ได้ลบข้อความหรือลิงก์สแปมบนหน้าเว็บของเรา Google ระบุว่าเว็บไซต์ส่วนใหญ่ไม่จำเป็นต้องใช้ |
แก้เว็บแล้วต้องทำอะไรใน Google Search Console
ก่อนส่งคำขอ ให้กำหนดก่อนว่าต้องการให้ URL นั้นหายจากผลค้นหา หรือยังต้องการให้แสดงเนื้อหาที่แก้แล้ว
| เป้าหมาย | แนวทาง |
|---|---|
| ต้องซ่อน URL สแปมอย่างเร่งด่วน | ใช้ Temporarily remove URL ควบคู่กับการแก้ถาวร |
| หน้าสินค้ายังใช้งาน แต่ snippet มีข้อความจากรีวิวที่ลบแล้ว | ให้ Google ตรวจหน้าใหม่ หากเร่งด่วนแนะนำให้ใช้ Clear snippet in search |
| หน้าปกติแก้แล้วและต้องการให้ค้นหาเจอ | ตรวจด้วย Test live URL แล้ว Request indexing |
| มี Security Issues หรือ Manual Actions | แก้ตามรายงาน แล้วขอ review ในรายงานนั้น |
ซ่อน URL จากผลค้นหาชั่วคราว
- เปิด property ที่ถูกต้องใน Search Console
- เข้า Removals → Temporary Removals → New Request
- เลือก Temporarily remove URL
- เลือกเฉพาะ URL หรือทุก URL ที่ขึ้นต้นด้วย prefix ที่ระบุ
- ตรวจขอบเขตก่อนส่ง โดยเฉพาะ prefix ที่อาจครอบคลุมหน้าปกติ
คำขอนี้ซ่อน URL ได้ประมาณ 6 เดือน หากไม่แก้เว็บไซต์ให้ได้ผลถาวร URL จะกลับมาแสดงเมื่อครบกำหนด
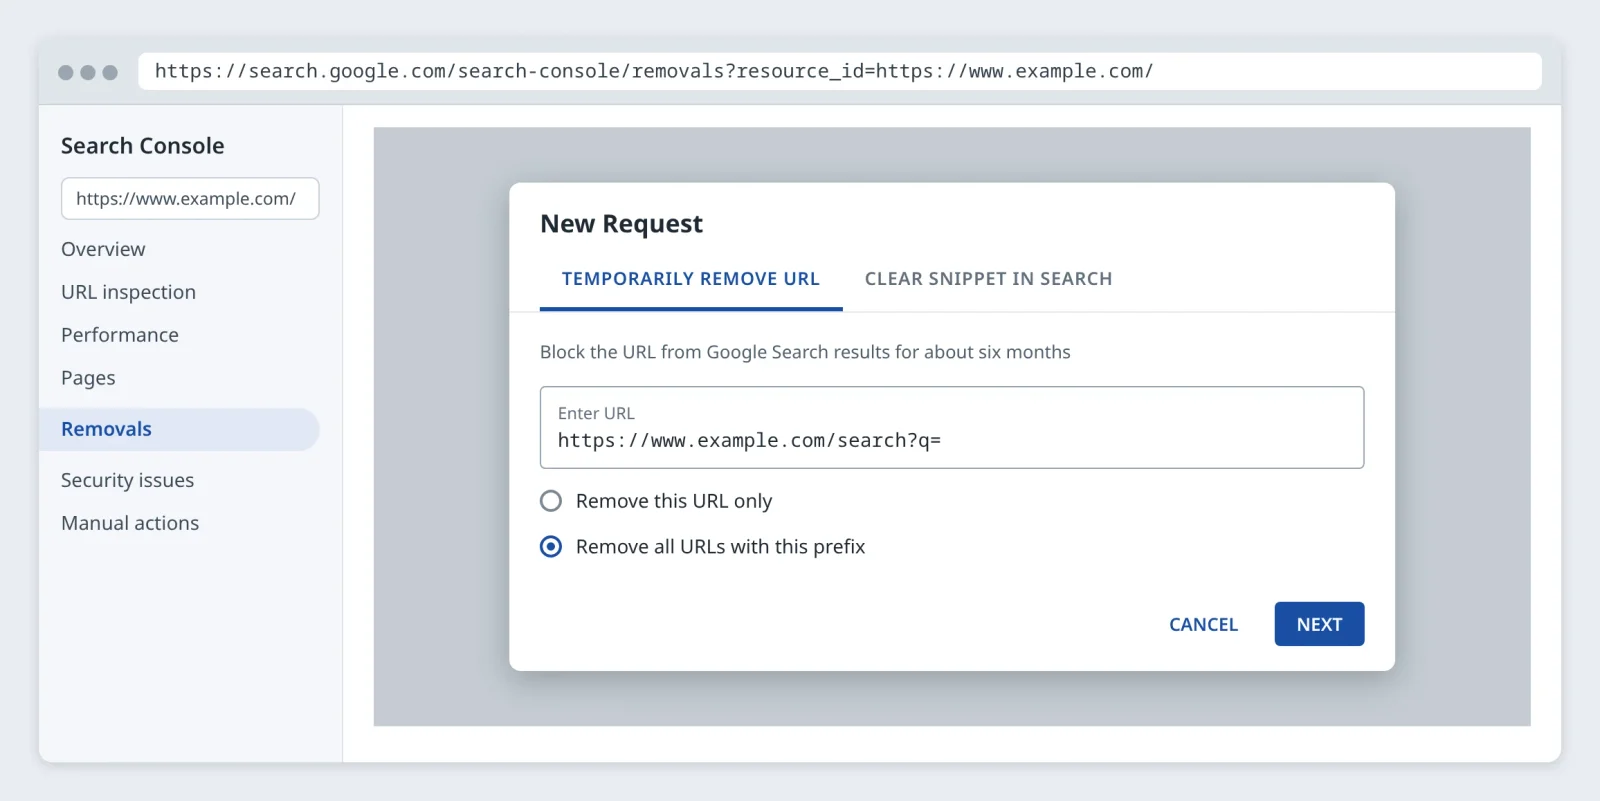 หน้า New Request ของเครื่องมือ Removals
ซ่อนได้ทั้ง URL เดียว หรือทุก URL ที่ขึ้นต้นด้วย prefix เดียวกัน เช่น ทุกหน้าค้นหาใต้ /search?q=
เคลียร์ข้อความเก่าที่ค้างใน snippet
หากลบสแปมออกจากหน้าแล้ว แต่ข้อความเก่ายังปรากฏใต้ผลค้นหา และยังต้องการให้หน้าสินค้าปรากฏตามปกติ แนะนำให้:
- เข้า Removals → Temporary Removals → New Request
- เลือก Clear snippet in search
- ระบุ URL ที่ได้รับผลกระทบและตรวจรายละเอียดก่อนส่ง
เครื่องมือนี้เคลียร์ข้อความตัวอย่างจนกว่าหน้าจะถูก index ใหม่ ไม่ได้ซ่อน URL แบบ Temporarily remove URL และระหว่างรอประมวลผลใหม่ หน้ายังอาจปรากฏเมื่อค้นด้วยคำที่ถูกลบไปแล้วได้
อีกข้อที่ต้องระวังคือ Removals ไม่จับส่วน fragment หลัง # การส่ง:
https://shop.example/products/shoe-123#review-456
จึงเท่ากับส่ง URL ของหน้าสินค้าทั้งหน้า ไม่ใช่รีวิวรายการเดียว รีวิวที่อยู่ในหน้าสินค้าต้องแก้ที่เนื้อหาหน้าสินค้า ส่วน /reviews/456 ที่เป็นเอกสารแยกจัดการตาม URL ของตัวเองได้
ให้ Google ตรวจหน้าปกติที่แก้แล้ว
ใช้ URL Inspection และ Test live URL ตรวจหน้าปัจจุบันก่อน จากนั้น Request indexing สำหรับหน้าที่ต้องการให้ปรากฏใน Google
สำหรับหน้าที่ตั้งใจใช้ noindex หรือ Response 404 Not Found / 410 Gone ให้คงการตั้งค่านั้นไว้ ไม่ต้องเปลี่ยนหน้าให้ index ได้เพื่อให้ส่งคำขอผ่าน
หากแก้หลายหน้าที่ต้องการให้แสดงในผลค้นหา ให้อัปเดต sitemap ด้วย การขอ crawl ไม่รับประกันว่าจะอัปเดตทันทีหรือถูก index และการส่งคำขอซ้ำไม่ได้ทำให้เร็วขึ้น
หากมีรายการใน Security Issues หรือ Manual Actions ให้แก้ปัญหาตามขอบเขตของรายงาน แล้วขอ review โดยอธิบายสาเหตุ สิ่งที่แก้ และผลตรวจหลังแก้ กระบวนการนี้แยกจาก Request indexing
ตรวจซ้ำและติดตามหลังแก้
ก่อนปิดงาน แนะนำให้ตรวจอย่างน้อยว่า:
- หน้า Search และ endpoint เก่าใช้ indexing policy ตามที่กำหนด
- Input แสดงเฉพาะตำแหน่งที่ตั้งใจ และไม่สร้าง markup, ลิงก์ หรือ redirect โดยไม่ตั้งใจ
- คำค้นใหม่ไม่สร้างหน้าสแปมที่พร้อมถูก index ด้วยกลไกเดิม
- รีวิวที่รออนุมัติหรือถูกลบแล้วไม่ปรากฏในข้อมูลสาธารณะ
- การแก้รีวิวและข้อมูลโปรไฟล์ยังผ่าน Rule การเผยแพร่ที่กำหนดไว้
- URL สแปมเดิมได้รับการจัดการถาวร
- มีการติดตามหลัง crawler กลับมาตรวจ โดยไม่อาศัยผล
site:เพียงครั้งเดียว - หากพบการเจาะระบบ มีการตรวจช่องทางเข้าและสิ่งที่ผู้โจมตีทิ้งไว้แล้ว
ควรกำหนดผู้รับผิดชอบแต่ละส่วนให้ชัดเจน ทีมพัฒนาดูแลฟังก์ชันค้นหาและรีวิว ทีมระบบตรวจ configuration, cache และ Logs ทีม SEO ติดตาม Search Console ส่วนทีม Security ตรวจผลกระทบและสาเหตุที่เกี่ยวข้อง
หากพบ URL หรือข้อความผิดปกติใน website ขององค์กร นำ URL ตัวอย่าง พฤติกรรมที่พบ และช่วงเวลาที่ตรวจเจอมาคุยกับทีม Incognito Lab เพื่อประเมินขอบเขตการตรวจได้ ดูรายละเอียดบริการ Web Application Penetration Test, Secure Code Review และ Incident Response สำหรับกรณีที่มีหลักฐานว่าระบบถูกเจาะ
ตัวอย่าง URL, HTML และ marker ใช้เพื่ออธิบายกลไกและแนวทางทดสอบ ชื่อเมนูของ Google Search Console อ้างอิงเอกสารที่ตรวจทานในเดือนตุลาคม 2026
แหล่งอ้างอิง
- Sucuri — NASA web site hacked and serving malware/spam, 21 ตุลาคม 2010
- PCWorld / IDG News Service — NASA, Stanford Websites Hit by Search Engine Scammers, 9 พฤษภาคม 2011
- Google Search Central — Prevent portions of your site from being abused by spam
- Google Search Central — Prevent user-generated spam on your site and platform
- Google Search Central — Qualify your outbound links to Google
- Google Search Central — Robots meta tag, data-nosnippet, and X-Robots-Tag specifications
- Google Search Central — Review snippet structured data
- OWASP Web Security Testing Guide — Testing for Reflected Cross Site Scripting
- Google Search Central — Link best practices for Google
- Google Search Central — site: search operator
- Search Console Help — URL Inspection tool
- Google Search Central — Block Search indexing with noindex
- Google Crawling Infrastructure — How HTTP status codes affect Google's crawlers
- Google Search Central — What is canonicalization
- Search Console Help — Disavow links to your site
- Search Console Help — Removals and SafeSearch reports tool
- Google Search Central — Ask Google to recrawl your URLs
- Search Console Help — Security issues report
- Search Console Help — Manual actions report
- OWASP Cheat Sheet Series — Input Validation
- OWASP Cheat Sheet Series — Cross Site Scripting Prevention
- Google Search Central — Spam policies for Google web search
Last reviewed: 26 Oct 2026
คำถามที่พบบ่อย
เจอคำโฆษณาเว็บพนันในผลค้นหาของโดเมนเรา แปลว่าเว็บถูกเจาะแล้วหรือไม่
ยังสรุปไม่ได้ ข้อความอาจมาจากหน้า Search ที่นำคำค้นใน URL มาแสดงกลับ หรือจากคอมเมนต์และรีวิวที่ผู้ใช้โพสต์ผ่านฟังก์ชันของเว็บไซต์ การยืนยันว่าระบบถูกเจาะต้องมีหลักฐานเพิ่มเติม เช่น การเข้าถึงหรือแก้ไขไฟล์ database และบัญชีผู้ดูแลโดยไม่ได้รับอนุญาต จึงควรตรวจ HTML ข้อมูลต้นทาง และ Logs ประกอบกัน
หน้า Search แสดงคำค้นกลับมา ถือเป็นช่องโหว่ XSS หรือไม่
การแสดงคำค้นเป็นข้อความธรรมดาเป็นพฤติกรรมปกติของหน้าค้นหา จะเรียกว่า XSS ได้ต้องพิสูจน์ว่า input ทำให้โค้ดทำงานใน browser ได้จริง ส่วน SEO spam อาจเกิดขึ้นได้แม้ escape HTML ถูกต้องแล้ว เพราะข้อความโฆษณายังปรากฏบนหน้าและอาจถูก index จึงต้องกำหนดนโยบาย indexing ของหน้าค้นหาด้วย
ใส่ rel="nofollow" ให้ลิงก์สแปมแล้ว เพียงพอหรือยัง
ยังไม่พอ nofollow และ ugc ใช้บอกความสัมพันธ์ของลิงก์กับเว็บไซต์ปลายทาง แต่ไม่ได้ลบข้อความสแปม ห้ามผู้อ่านกดลิงก์ หรือนำหน้าต้นทางออกจากผลค้นหา หากยืนยันแล้วว่าเป็นสแปม ควรลบออกทันที ส่วน rel="ugc" ใช้กับลิงก์จากผู้ใช้ที่ตั้งใจให้เผยแพร่เท่านั้น
ถ้ารีวิวสินค้ามีสแปม ควรใส่ noindex ที่หน้าสินค้าหรือไม่
หากยังต้องการให้สินค้านั้นปรากฏใน Google ไม่ควรใส่ noindex ทั้งหน้า เพราะจะกันเนื้อหาสินค้าที่ถูกต้องออกจากผลค้นหาไปด้วย ควรลบรีวิวสแปมออกจากทุกจุดที่เผยแพร่ ทั้ง HTML, API, JSON-LD และ cache แล้วให้ Google ตรวจหน้าที่แก้แล้ว หากข้อความเก่าค้างใน snippet และต้องจัดการเร่งด่วน แนะนำให้ใช้ Clear snippet in search ในเครื่องมือ Removals
ใช้ Removals ใน Search Console แล้ว ทำไมสแปมกลับมาอีก
Temporarily remove URL ซ่อนผลค้นหาชั่วคราวประมาณ 6 เดือน หากหน้าเดิมยังเปิดให้ index ได้ หรือระบบยังสร้าง URL สแปมใหม่ได้ ปัญหาก็อาจกลับมา จึงต้องแก้เว็บไซต์ควบคู่กัน เช่น กำหนด noindex ให้หน้า Search ที่ไม่ต้องการให้ปรากฏใน Google Response 404 Not Found หรือ 410 Gone ให้หน้าที่ลบแล้ว และปิดช่องทางที่ทำให้มีการเผยแพร่สแปม
ค้นด้วย site: แล้วไม่เจอคำพนัน แปลว่าเว็บไม่มีสแปมหรือไม่
ยังสรุปไม่ได้ ผลจาก site: ไม่ใช่รายการ URL ทั้งหมดที่ Google เก็บไว้ ควรตรวจร่วมกับ Performance report และ URL Inspection ใน Search Console รวมถึง Logs และการทดสอบฟังก์ชันค้นหา คอมเมนต์ และรีวิวโดยตรง
PENETRATION TEST
With our high-ethical, professional certified team and methodology based on NIST SP800-115, we offer a full range of cost-effective services to identify your cyber risks in application, infrastructure, and mobile platforms to meet the requirements of your organisation.
Up Next
ARTICLES/15 Feb 2018
SANS Holiday Challenge 2017 Write-up Part 3
Write-up SANS Holiday Hack Challenge 2017 ตอนที่สาม ส่วนที่ยาวและยากที่สุด ว่าด้วยการเจาะ Letters to Santa application เพื่อหา The Great Book
ARTICLES/17 Sep 2026
OWASP Top 10 for LLM 2026: เมื่อ AI Agents และ RAG กลายเป็น Attack Surface ใหม่
ภาพรวมของ OWASP Top 10 for LLM ฉบับ 2026 เจาะ Excessive Agency, ช่องโหว่ RAG และ Tool Poisoning พร้อมตัวอย่าง Indirect Prompt Injection และแนวทาง Secure by Design
ARTICLES/25 Aug 2026
วิเคราะห์ CVE-2026-54121 - CertiGhost
CertiGhost (CVE-2026-54121) ช่องโหว่ใน AD CS ที่ให้ domain user สิทธิ์ต่ำปลอมตัวเป็น DC และขยายผลไปยึด domain ได้

